WhisperX 歌词
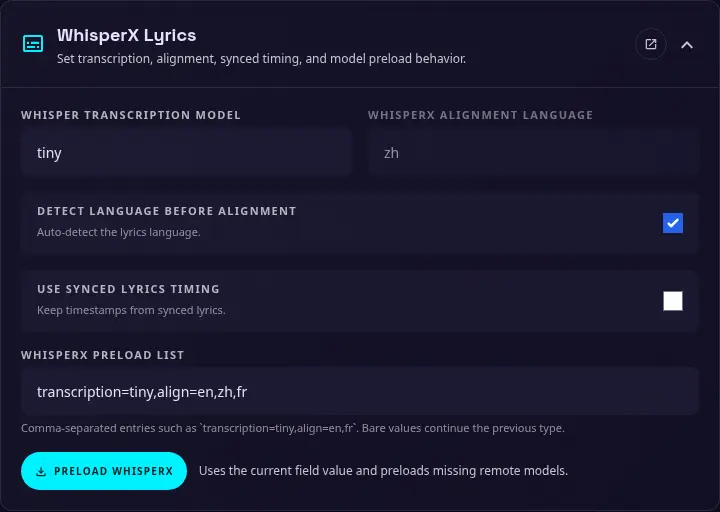
WhisperX 会根据纯文本歌词或 LRC 歌词生成逐字卡拉 OK 时间轴。处理过程中,主应用会将歌词和分离后的人声轨道发送给 Demucs 服务。WhisperX 会检测语言,使歌词与人声对齐,并返回包含完整同步歌词的 JSON 文件。
使用此页面配置 WhisperX 的语言和对齐工作流。部署需要固定值时,也可以通过环境变量配置这些设置。
WhisperX 转录模型
用于语言检测的 WhisperX 转录模型。默认值为 tiny,因为语言已知时,后端无需转录完整音频。
WhisperX 对齐语言
WhisperX 用于对齐的语言。请输入语言代码,例如 en 或 zh。
在语言检测和固定语言之间选择
如果卡拉 OK 媒体库包含多种语言的歌曲,请启用语言检测。WhisperX 会选择合适的对齐模型,对不熟悉技术设置的用户来说,自动检测通常更方便。单首歌曲可以覆盖检测到的语言。
如果媒体库主要使用一种语言,请手动指定该语言。这样可以避免不必要的检测,减少因选择错误模型而导致对齐结果不准确、卡拉 OK 时间轴质量较差的可能性。手动指定语言后,可以跳过语言检测转录步骤。
转录前检测语言
启用后,WhisperX 会在对齐前检测音频语言并选择合适的模型。
使用同步歌词时间轴
此选项默认禁用,建议保持禁用。WhisperX 可以接受同步 LRC 行,例如 [0:01.000] line。这些行会为每句歌词提供一个时间戳,有助于提高对齐速度。
不过,外部来源的歌词很少与卡拉 OK 使用的视频或音频同步。因此,使用这些时间戳可能会降低逐词对齐的质量。
WhisperX 预加载列表
这是 WhisperX 用于提前下载和加载模型的逗号分隔列表。默认值为 transcription=tiny,align=en。条目使用 type=model 格式,例如:
transcription=tiny:预加载用于语言检测的转录模型。align=en:预加载英语对齐模型。align=zh:预加载中文对齐模型。
模型必须下载后才能使用。预加载 WhisperX按钮会在第一个卡拉 OK 处理任务开始前,提前下载并加载配置的模型。