Letras de WhisperX
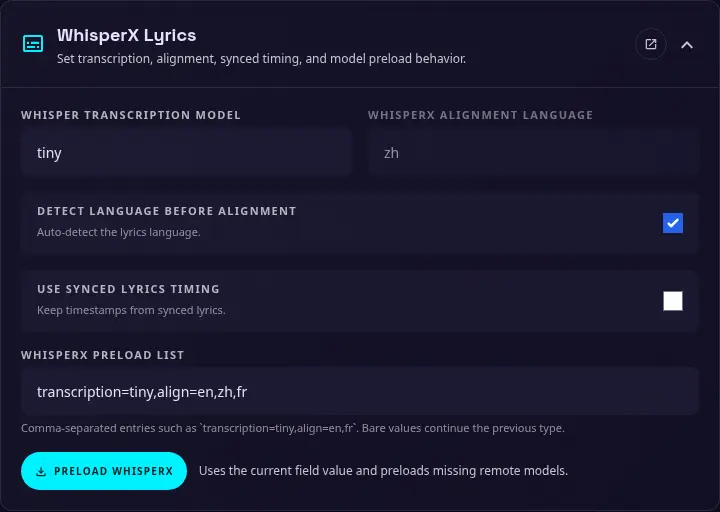
WhisperX crea tiempos de karaoke palabra por palabra a partir de letras de texto sin formato o LRC. Durante el procesamiento, la aplicación principal envía las letras y la pista vocal separada al servicio Demucs. WhisperX detecta el idioma, alinea las letras con las voces y devuelve un archivo JSON que contiene letras totalmente sincronizadas.
Use esta página para configurar el flujo de trabajo de idioma y alineación de WhisperX. Estos ajustes también se pueden establecer con variables de entorno cuando una implementación necesita valores fijos.
Modelo de transcripción de WhisperX
El modelo de transcripción que WhisperX utiliza para detectar el idioma. El valor predeterminado es tiny, recomendado porque el backend no necesita transcribir el audio completo cuando ya se conoce el idioma.
Idioma de alineación de WhisperX
El idioma que WhisperX utiliza para la alineación. Introduzca un código de idioma como en o zh.
Elija entre detección de idioma y un idioma fijo
Active la detección de idioma para una biblioteca de karaoke con canciones en varios idiomas. WhisperX puede elegir el modelo de alineación adecuado, y la detección automática suele ser más sencilla para invitados menos técnicos. Las canciones individuales pueden anular el idioma detectado.
Si su biblioteca está principalmente en un idioma, especifique ese idioma manualmente. Así evita una detección innecesaria y la posibilidad de que un resultado impreciso seleccione el modelo equivocado y produzca una mala sincronización de karaoke. Cuando se especifica un idioma manualmente, se puede omitir el paso de transcripción para detectar el idioma.
Detectar el idioma antes de la transcripción
Active esta opción para que WhisperX detecte el idioma del audio antes de la alineación y seleccione el modelo adecuado.
Usar tiempos de letras sincronizadas
Esta opción está desactivada de forma predeterminada y se recomienda mantenerla desactivada. WhisperX puede aceptar líneas LRC sincronizadas, como [0:01.000] línea, que proporcionan marcas de tiempo individuales para cada línea de letra y pueden mejorar la velocidad de alineación.
Sin embargo, las letras de fuentes externas rara vez están sincronizadas con el vídeo o audio usado para karaoke. Por ello, usar esas marcas de tiempo puede producir una calidad de alineación a nivel de palabra inferior.
Lista de precarga de WhisperX
La lista separada por comas de modelos WhisperX que se deben descargar y cargar por adelantado. El valor predeterminado es transcription=tiny,align=en. Las entradas usan el formato type=model, por ejemplo:
transcription=tiny: precarga el modelo de transcripción utilizado para detectar el idioma.align=en: precarga el modelo de alineación en inglés.align=zh: precarga el modelo de alineación en chino.
Los modelos se deben descargar antes de poder utilizarlos. El botón Precargar WhisperX descarga y carga los modelos configurados por adelantado, antes del primer trabajo de procesamiento de karaoke.